
要点速览
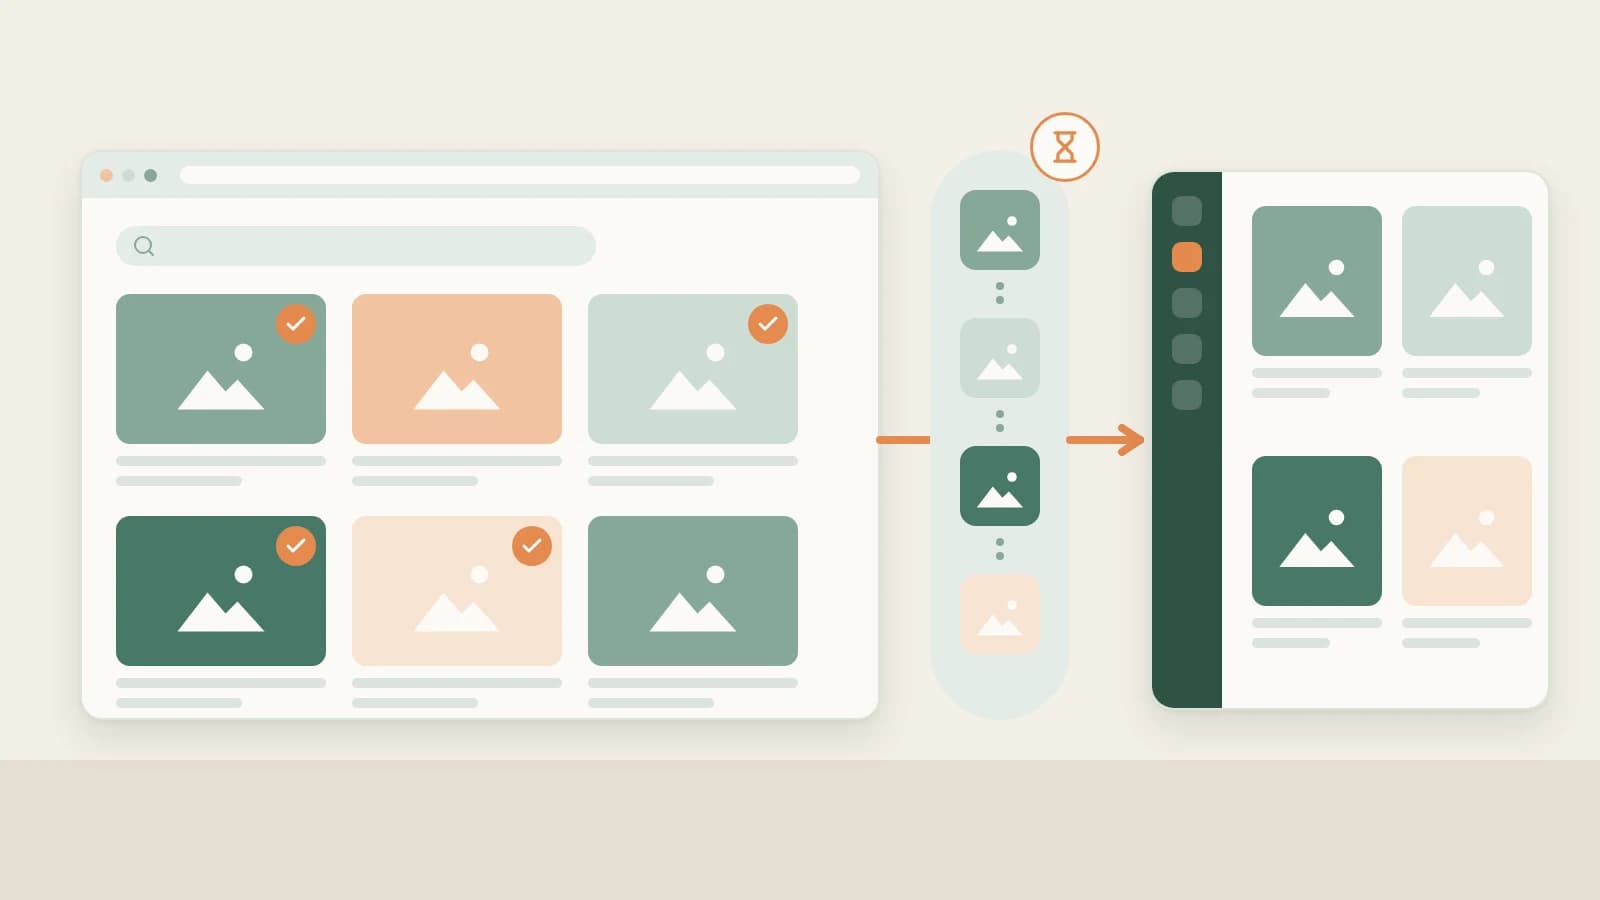
- Beav 浏览器插件在小红书的搜索页、信息流和博主主页都可以发起批量采集,批量任务进入同一个后台队列,笔记存进当前空间的知识库。
- 它在你自己已经登录的浏览器里工作,不用写采集规则,存下来的是带来源的笔记条目,可以直接拆解、交给 AI 引用。
- 请控制数量和间隔,不要同时从多个页面发起大批量任务;遇到验证页先停下,完成验证再继续。
找对标的时候,一条条点开保存很慢。搜一个关键词,前几屏都是想参考的笔记;看到一个好博主,想把他最近的内容都存下来研究。这时候需要的是批量采集。
Beav 浏览器插件把这件事放在你平时刷小红书的页面里:在搜索结果、信息流或博主主页发起,后台慢慢存,你回 Beav 里看结果就行。
适合谁
- 刚开始做一个赛道,想一次存下一批对标笔记做研究的创作者。
- 需要定期把几个对标博主的近期内容存下来拆解的运营。
- 不想学采集软件、也不需要导出表格,只想要可以直接用的素材的人。
怎么用
先装好 Beav 桌面端和浏览器插件,确认插件已连接、当前空间正确。没装的话看入门教程 02。
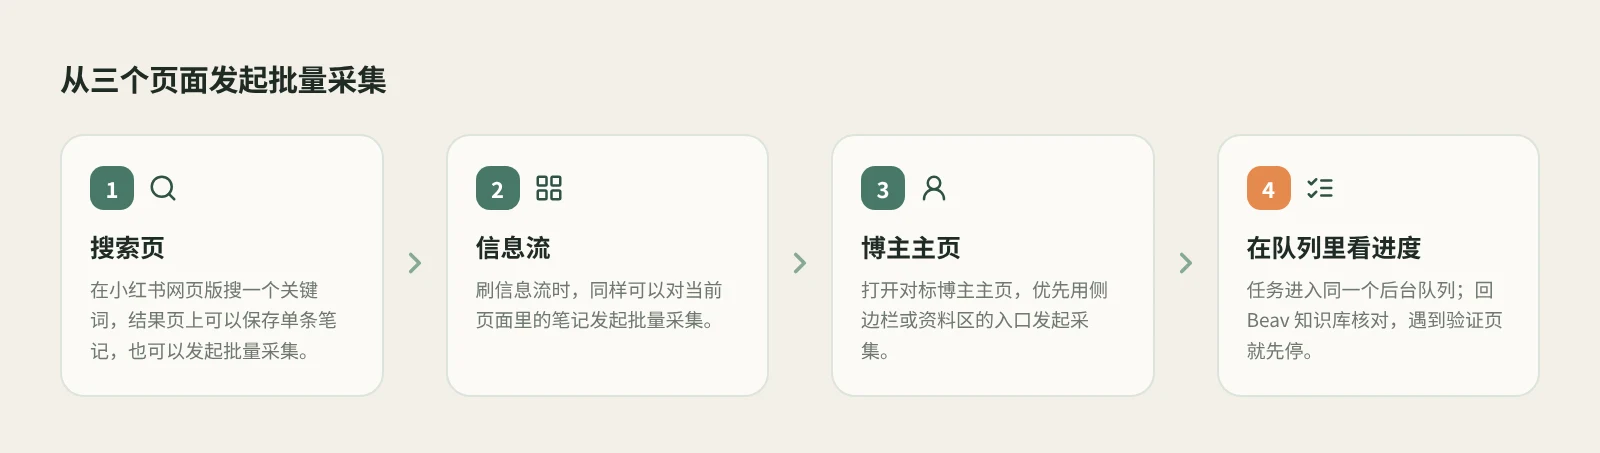
- 确认空间。 批量存下来的笔记会进 Beav 当前打开的工作空间。一个账号一个空间的话,先切到对的那个。
- 从页面发起。 在电脑上的 Chrome 或 Edge 打开小红书:
- 搜索页:搜一个关键词,可以保存单条笔记,也可以对结果发起批量采集。
- 信息流:刷到的当前页面同样可以发起批量采集。
- 博主主页:打开对标博主的主页,优先用侧边栏或资料区的入口。
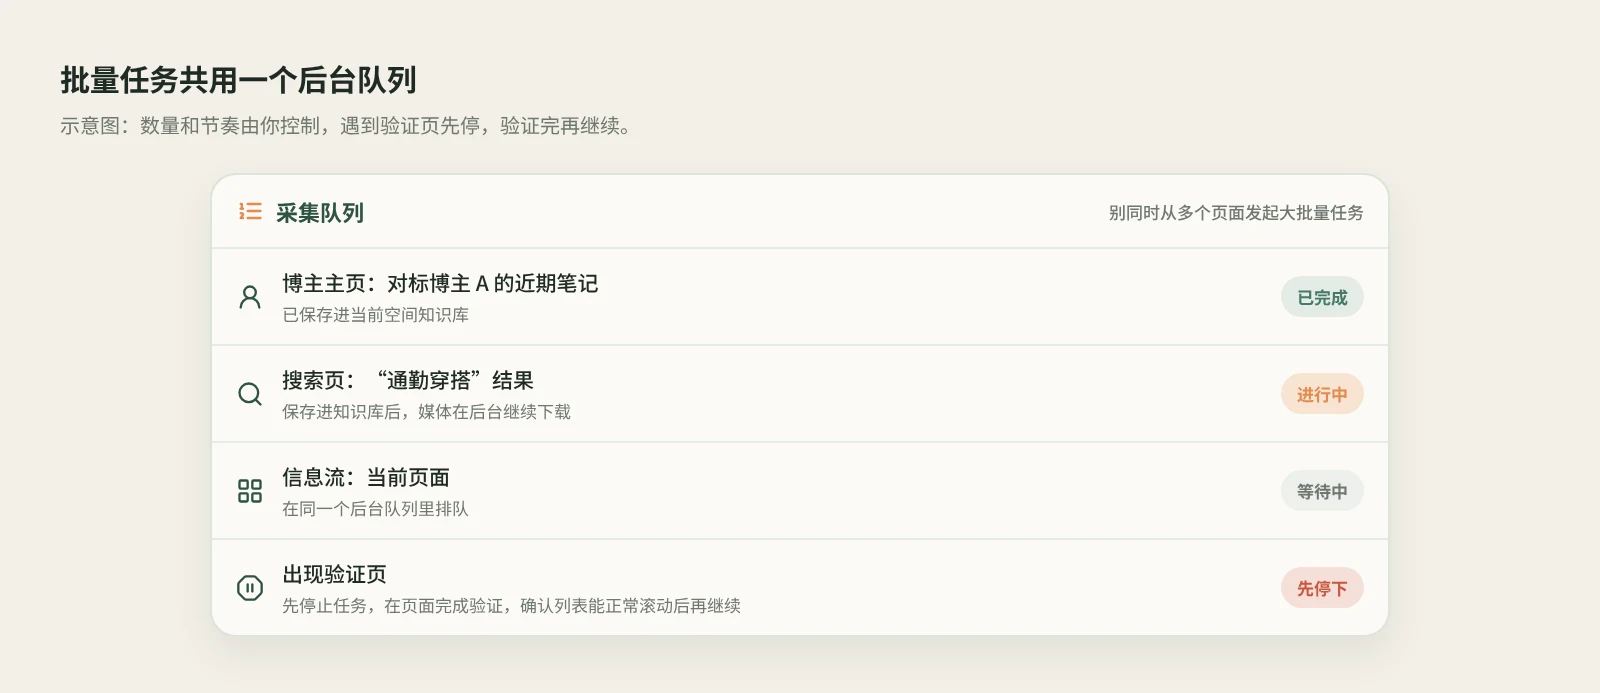
- 看队列。 批量任务都进入同一个后台队列,进度和历史可以在插件侧边栏查看。
- 回 Beav 核对。 在知识库里确认来源链接、正文和媒体。媒体在后台下载,卡片显示“下载中”是正常的。
- 需要的话再批量拆解。 存好后在知识库多选,右键“拆解选中的 N 项”,一次最多 100 条,开始前会确认条数和模型消耗。
和采集器、数据平台导出比有什么不同
| 通用采集器(如八爪鱼) | 数据平台导出 | Beav 浏览器插件 | |
|---|---|---|---|
| 怎么开始 | 点选配置采集规则或用现成模板 | 在平台里筛选后导出 | 在小红书搜索页、信息流、博主主页直接发起 |
| 在哪运行 | 本机或云端采集 | 平台方的服务 | 你自己已登录的浏览器,结果存进本机 Beav |
| 得到什么 | 表格或数据库里的字段 | 报表和数据表 | 一条条完整笔记:正文、图片或视频、来源链接 |
| 擅长 | 规模大、字段可定制、能定时跑 | 覆盖面广,有历史数据和排行 | 存下来就能拆解、仿写,写稿时交给 AI 引用 |
| 要注意 | 规则要维护,页面一改就要调 | 通常需要付费账号 | 数量和间隔要自己控制,遇到验证页要停 |
如果你要的是成千上万条数据做统计,通用采集器和数据平台更合适,它们本来就是为这个设计的。Beav 的批量采集是为创作服务的:你挑出一批真正想研究的笔记,存成能接着用的素材,量不需要很大。
边界和注意
- 控制数量和节奏。 一次采一批够用的就好,不要同时从多个页面发起大批量任务。这是在你自己的账号和浏览器里进行的,节奏不正常的访问可能触发平台验证。
- 遇到验证页先停。 站点验证、页面刷新、网络波动或访问限制都会让任务中断。先停止当前任务,在页面完成验证,确认列表能正常滚动后再继续,具体见小红书批量采集中断。
- 能存到什么取决于页面实际提供的内容。存下来的笔记供你自己研究参考,转载或商用前请取得作者授权。
- 拆解会调用模型并消耗额度,不需要每条都拆,挑重点即可。
下一步
- 单篇怎么存、存下来有什么,读小红书笔记怎么完整存到电脑。
- 存评论的笔记可以用评论区洞察分析读者在问什么。
- 想搭一个长期的对标素材池,读用浏览器插件搭建对标爆款素材池,或看小红书插件。
适用于 Beav 桌面端 2.9 与浏览器插件 2.7,核对日期 2026-10-21。