
要点速览
- 不要指望一个模型包办所有事。一条内容从采集到发布,会经过转写、看图、判断、写作、生图、配音等不同环节,每个环节需要的能力和预算都不一样。
- 分工的原则很简单:判断题交给小模型,没人盯着的后台任务用便宜快的模型,你亲自参与的创作才用最好的模型;听、看、画、说这些专项能力,交给专门的模型。
- Beav 在“设置 → AI 模型 → 模型能力设置”里把这些环节拆成 11 项,每项单独选模型。决策、自动化、视频分析这几项没单独设置时,会退回对话模型或视觉模型;用官方账号登录时,空着的用途会自动补上官方默认模型。
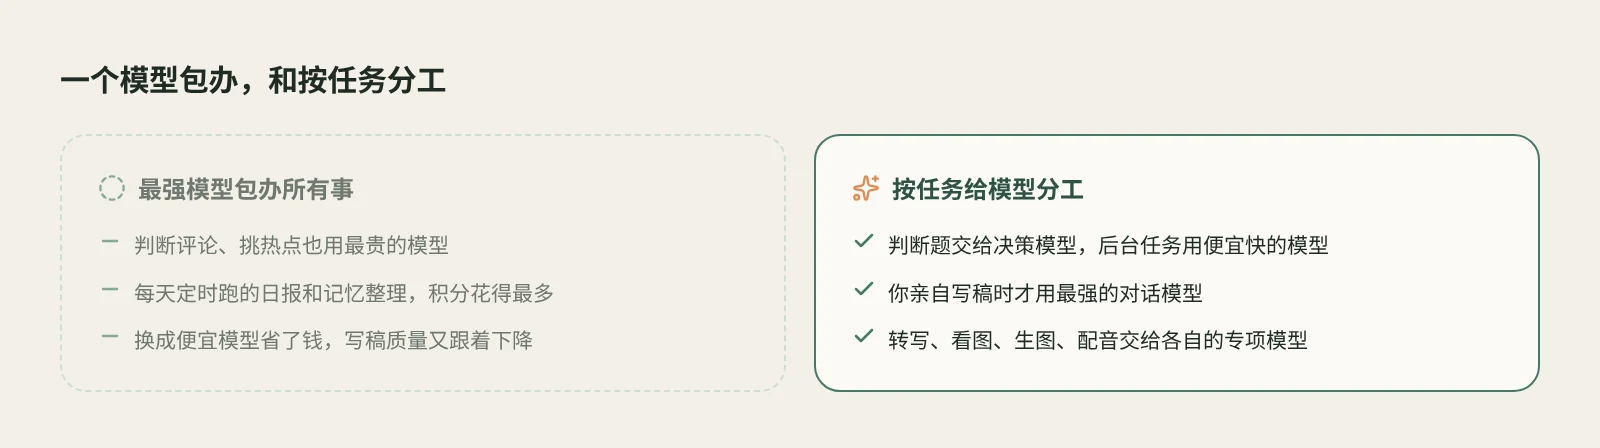
很多创作者用 AI 的方式是:找一个公认最强的模型,什么都交给它。写稿是它,判断评论是不是在问价格也是它,每天早上自动跑的日报还是它。效果当然不差,问题是贵,而且慢;一天跑下来,大部分积分花在了根本不需要最强模型的地方。
反过来全用便宜模型,写出来的稿子又差点意思。
更好的做法是像带团队一样给模型分工:谁擅长什么、哪活值得多花钱,各管一摊。这篇先讲分工的思路,再拿 Beav 里实际的模型编排做例子,最后给一份可以直接照着配的方案。
一条内容要用到几类模型
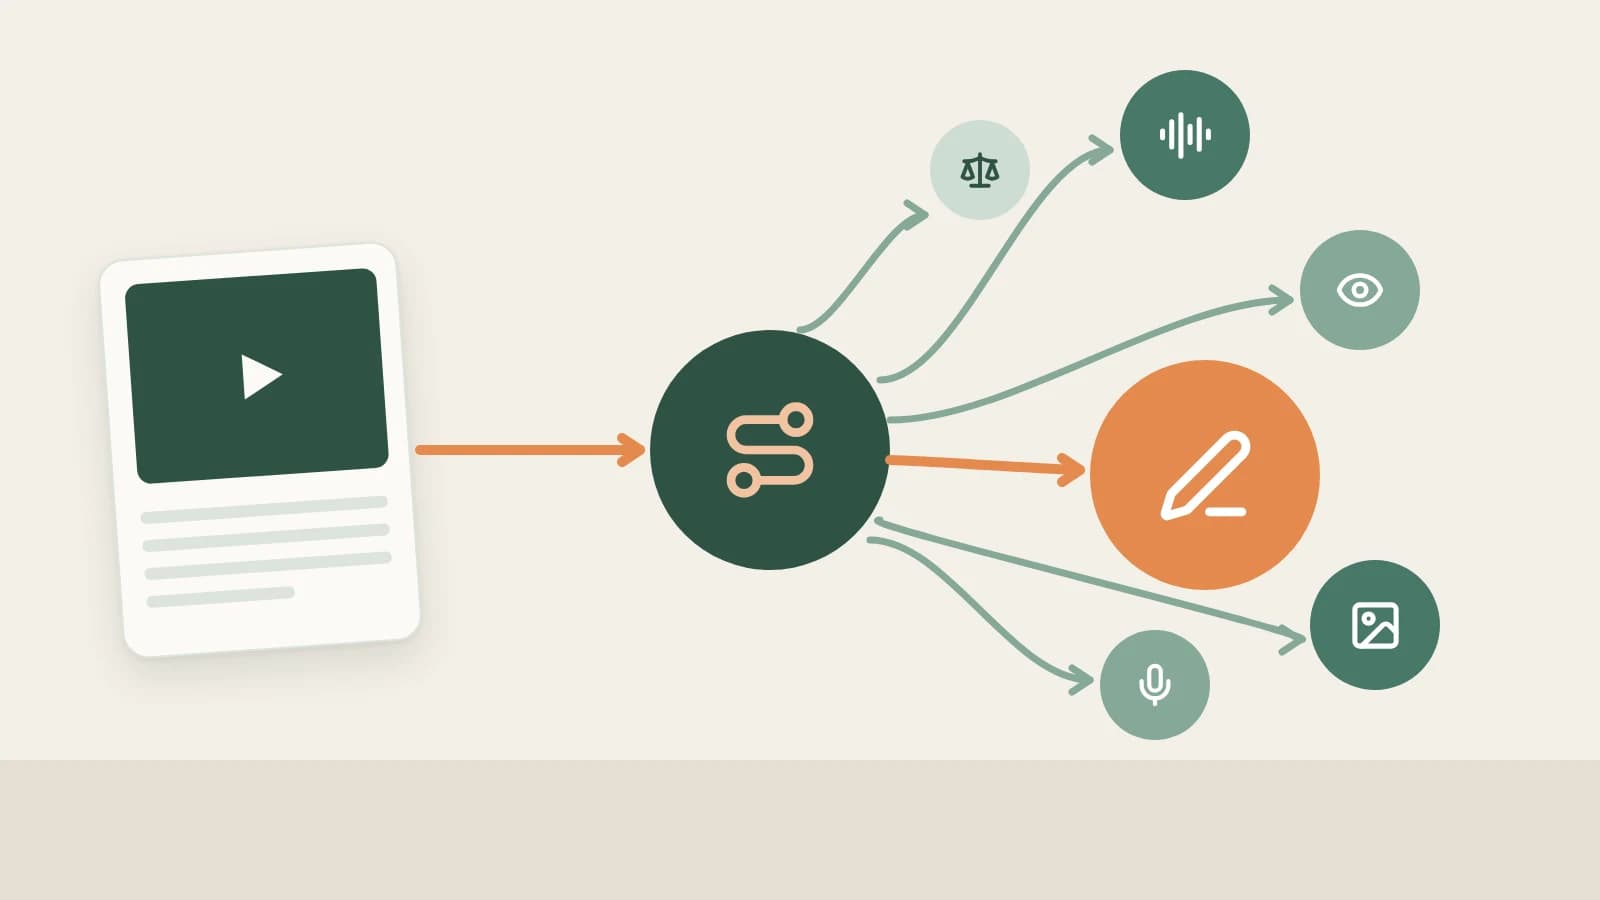
先把创作流程拆开看。以“刷到一条对标视频,拆解后写一篇自己的”为例:
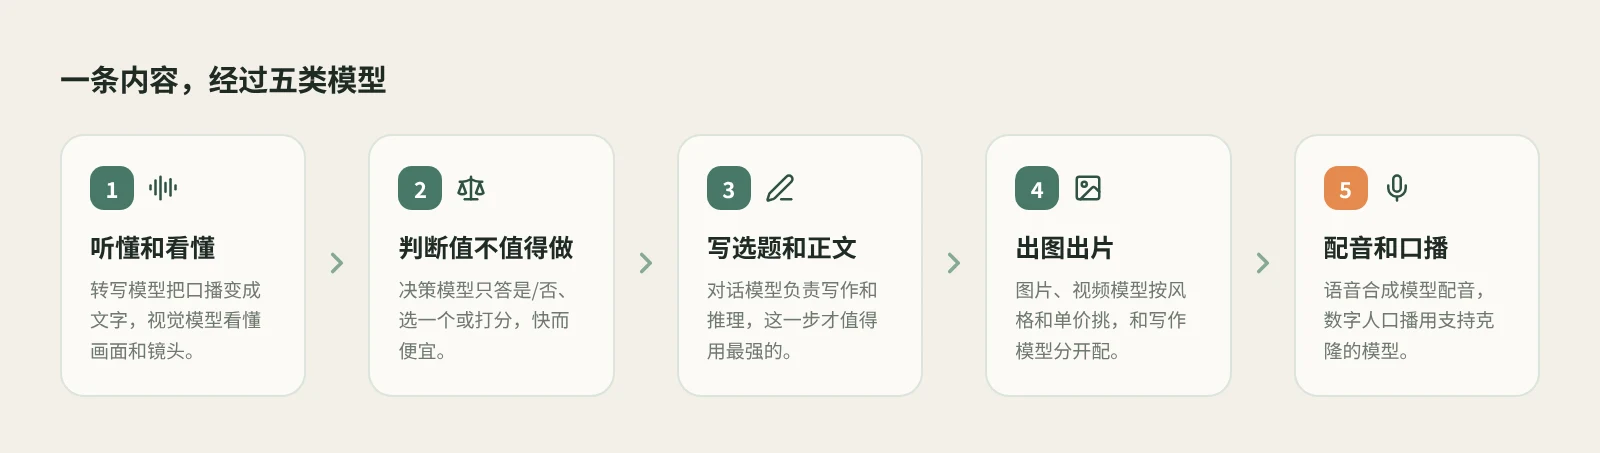
| 环节 | 需要的能力 | 选模型时看什么 |
|---|---|---|
| 听懂视频说了什么 | 语音转文字 | 中文识别准不准、带不带时间轴、按时长计费多少 |
| 看懂画面和图片 | 视觉理解 | 能不能看视频、能看多长、对镜头和画面的描述细不细 |
| 判断值不值得做 | 是/否、多选一、打分 | 快、便宜,按输入计费就够 |
| 写选题、脚本和正文 | 写作和推理 | 文笔、理解你的风格、能不能稳定调用工具 |
| 出封面、配图和视频 | 图片、视频生成 | 风格、中文字体、参考图能力、单张或单秒价格 |
| 配音和数字人口播 | 语音合成、音色克隆 | 音色自然度、语气控制、是否支持克隆 |
这张表里,真正需要“最强大脑”的只有写作那一行。其他环节要么是专项能力(听、看、画、说),要么是量大但简单的判断题。
四条分工原则
1. 判断题交给小模型
“这 50 条评论里哪些在问价格”“这个热点适不适合我的账号”“这段对话有没有值得记住的”,这类问题的答案只是是/否、选一个或打个分,不需要写一个字。
用对话模型做这种事,等于请主笔去分拣快递。专门做判断的小模型速度快、按输入计费,成本低得多,而且判断题天然量大,省下来的积分很可观。
2. 没人盯着的后台任务,用便宜快的模型
每天自动生成的运营日报、定时跑的选题分析、整理长期记忆,这些任务次数多、按时自动跑,你通常只看结果。它们需要的是稳定和便宜,不需要最好的文笔。
把后台任务和你亲自聊的对话分开配模型,是最容易省钱的一步。
3. 你亲自参与的创作,才用最好的模型
写正文、改脚本、和 AI 反复打磨一个选题,这时候模型质量直接决定成品,值得用最好的。也不必一直用同一个:头脑风暴时用快的模型多出几版,定稿时再换强模型精修,是很常见的用法。
4. 听、看、画、说,交给专门的模型
对话模型能连通,不代表它能看视频、能生图或者能配音。转写有专门的语音识别模型,看画面有视觉模型,封面有图片模型,配音有语音合成模型。专项模型在各自的事上更准,往往也更便宜。
Beav 是怎么编排模型的
道理不难,难的是落地:如果每做一件事都要手动挑模型,没人坚持得下来。Beav 的做法是把分工写进设置里,配一次,之后各个功能自动按用途找对应的模型。
11 项模型能力,各管一摊
在“设置 → AI 模型”的“模型能力设置”里,每一项用途单独选供应商和模型:
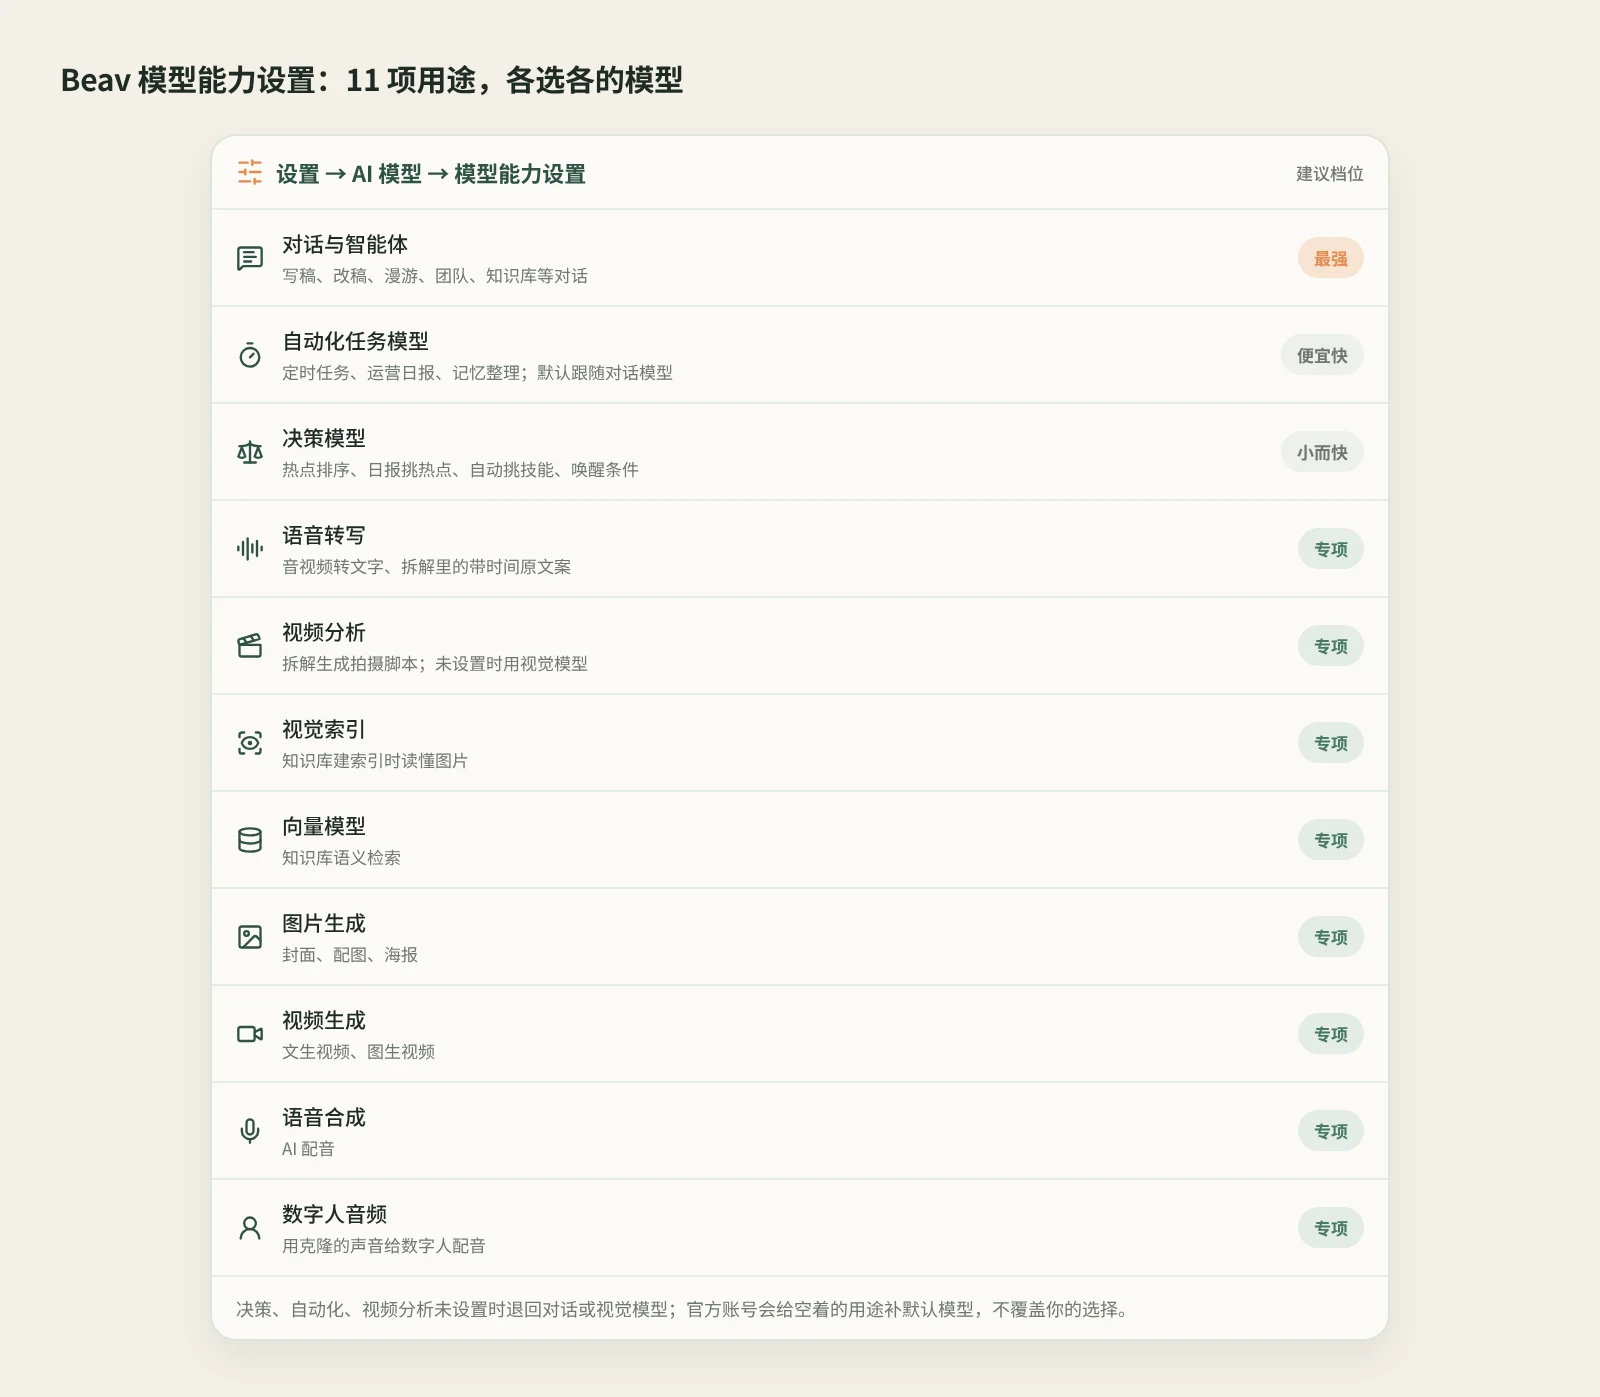
| 用途 | Beav 里用在哪 | 建议 |
|---|---|---|
| 对话与智能体 | 你发起的对话、写稿、改稿,以及漫游、团队、知识库等模式 | 用你最满意的强模型 |
| 自动化任务模型 | 定时任务、运营日报、自动运营、记忆整理、素材入库审查 | 便宜、快的模型;默认“跟随对话模型” |
| 决策模型 | 热点按账号定位排序、日报挑热点、判断对话值不值得记、新对话自动挑技能、定时任务的唤醒条件 | 小而快的判断模型 |
| 语音转写 | 音视频转文字、拆解里带时间的原文案 | 中文识别好的语音识别模型 |
| 视频分析 | 拆解生成拍摄脚本、标出真人出镜和空镜 | 能看视频的视觉模型 |
| 视觉索引 | 知识库建索引时读懂文档和素材里的图片 | 便宜的视觉模型即可 |
| 向量模型 | 知识库的语义检索 | 向量模型,配好后少动 |
| 图片生成 | 封面、配图、海报 | 按风格和单张价格选 |
| 视频生成 | 文生视频、图生视频 | 按画质、时长和价格选 |
| 语音合成 | AI 配音 | 按音色和语气控制选 |
| 数字人音频 | 数字人口播用你克隆的声音配音 | 只列出支持克隆的模型 |
几个具体例子:
- 拆解一条视频,会同时用到三个模型。 带时间的原文案走语音转写,选题和结构走对话模型,拍摄脚本走视频分析。批量拆解开始前,确认框会说明每条会调用转写、对话和视频理解模型。某一步的模型不可用,其他部分照常保存,结果底部会写明哪一步没完成。
- 运营日报跑在自动化任务模型上。 日报里“挑哪些热点”这一步,配了决策模型就先交给决策模型判断。你点开日报接着聊,又回到对话模型。
- 新对话的第一句话,决策模型会帮你挑技能。 你没有 @ 任何技能时,它判断哪个技能最合适:很有把握就直接用上,有一定把握只给出推荐,你点“启用”才生效。
少配几项也能用
不是每个人都愿意把 11 项配齐。用官方账号登录时,空着的用途会自动补上官方默认模型;几项“可选”的用途还各有退路:
- 决策模型没设置或出错时,用到它的地方照旧用对话模型。
- 自动化任务模型选“跟随对话模型”时,后台任务和以前一样用对话模型;它设置的模型不可用时也会自动退回对话模型。对话模型用官方线路时,会自动填上官方推荐的自动化模型,你随时可以换。
- 视频分析没单独设置时,用已配置的视觉模型。
- 看图:当前对话模型本身支持图片,就直接把图片交给它;不支持时,再用配置的视觉模型。
还有两条规矩,保证“自动”不会变成“乱来”:
- 你选过的不会被覆盖。 登录官方账号后,Beav 只给还空着的用途补上官方默认模型;你已经选好的官方、第三方或本地模型都保持原样,官方默认值以后变化也不会改掉你的选择。
- 不会偷偷换模型。 官方模型下架时,Beav 只在确认官方目录里它确实不可用后,换成同一类用途的官方默认模型。你自己接入的第三方和本地模型不可用时会明确报错,不会跨供应商换成别的模型。
对话里随时切换,会话会记住
新对话输入框里可以直接选聊天模型。手动选的模型会跟着这个会话保存,下次打开还是它;没有手动选的会话,按当前设置里的默认模型走。
所以“头脑风暴用快模型、定稿换强模型”在 Beav 里很顺手:同一个对话中途切换模型,已经写好的正文和工具结果都会保留。官方模型名字右侧会显示相对官网价格的倍率(例如 ×0.60),切换前就能看到大概的成本差别。每条 AI 回复底部也会显示这一次实际消耗的积分。
一份可以直接照着配的方案
不知道从哪开始,可以按下面三档来。具体有哪些模型、什么价格,以模型与价格页为准。
省心档:只配一个对话模型。 用官方模型登录后,其他用途会自动补上官方默认模型,自动化任务模型也会填上官方推荐的那个。适合刚开始用、不想折腾的人。
省钱档:在省心档基础上,加两项。
- 配一个决策模型。热点排序、日报挑选、自动挑技能这些判断题从对话模型上挪走。
- 把自动化任务模型从“跟随对话模型”改成一个便宜、快的模型。每天定时跑的任务越多,省得越多。
这两步不影响你亲自写稿的质量,是性价比最高的调整。
质量档:按环节逐项调。
- 对话模型选你最满意的那个,专心用来写。
- 视频分析选对视频理解最好的模型,拆解出的拍摄脚本会更细。
- 图片生成按你的封面风格选,多试几个,留下出图最稳的。
- 语音合成、数字人音频按音色挑;数字人口播要用你克隆的声音,在数字人音频里选支持克隆的模型。
- 已经有自己的 API 或本地模型,可以在“添加供应商”或“添加本地”里接进来,只替换其中几项。比如对话用自己的 API,生图仍用官方模型。
容易踩的坑
- 换对话模型不会换图片模型。 聊天模型和图片、视频生成模型分别配置,改了一项,其他项不动。
- 聊天能连通,不代表什么都能做。 第三方模型能聊天,不等于上游支持工具调用、看图或生图,要在对应用途里单独确认。
- 决策模型的结果只作参考。 它做初筛很合适,比如从几百条评论里先挑出问价格的,最终判断仍然在你。
- 外部 Agent 看图用它自己的模型。 通过 MCP 连接的外部 Agent 看 Beav 里的图片时,Beav 把图片原样交给它,由它自己的模型去看,不扣 Beav 看图模型的额度。
- 自定义模型是会员权益。 调用自己接入的第三方 AI 和本地模型需要会员;官方模型除了标“会员专属”的,所有人都能用。以设置页的提示为准。
下一步
- 接入第三方或本地模型的具体步骤:账号、积分与模型设置。
- 看一次拆解里三个模型怎么配合:视频拆解与拍摄脚本。
- 看自动化任务模型每天在跑什么:运营日报。
- 所有官方模型的介绍和价格:模型与价格。
适用于 Beav 桌面端 2.10,核对日期 2026-10-26。