
要点速览
- 视频号口播视频存进知识库、下载到本机后,在详情手动点“拆解”。结果有选题、结构模板、镜头、逐镜拍摄脚本和带时间戳的原文案,文案、关键帧、分镜 MP4 和配乐 M4A 复制到素材库的
decompositions/<标题>。- 学口播,最该看的是带时间戳的原文案和逐镜脚本:一句话说多久、在哪里停顿、什么时候切到画面,都摆在眼前。看懂之后点“AI 仿写”,按它的结构写你自己的口播稿。
- 拆解消耗模型额度,仿写使用对话模型。配乐来自没有说话但有声音的区间,可能含环境声,不是人声分离。仿写学的是结构和讲法,不是照搬原话。
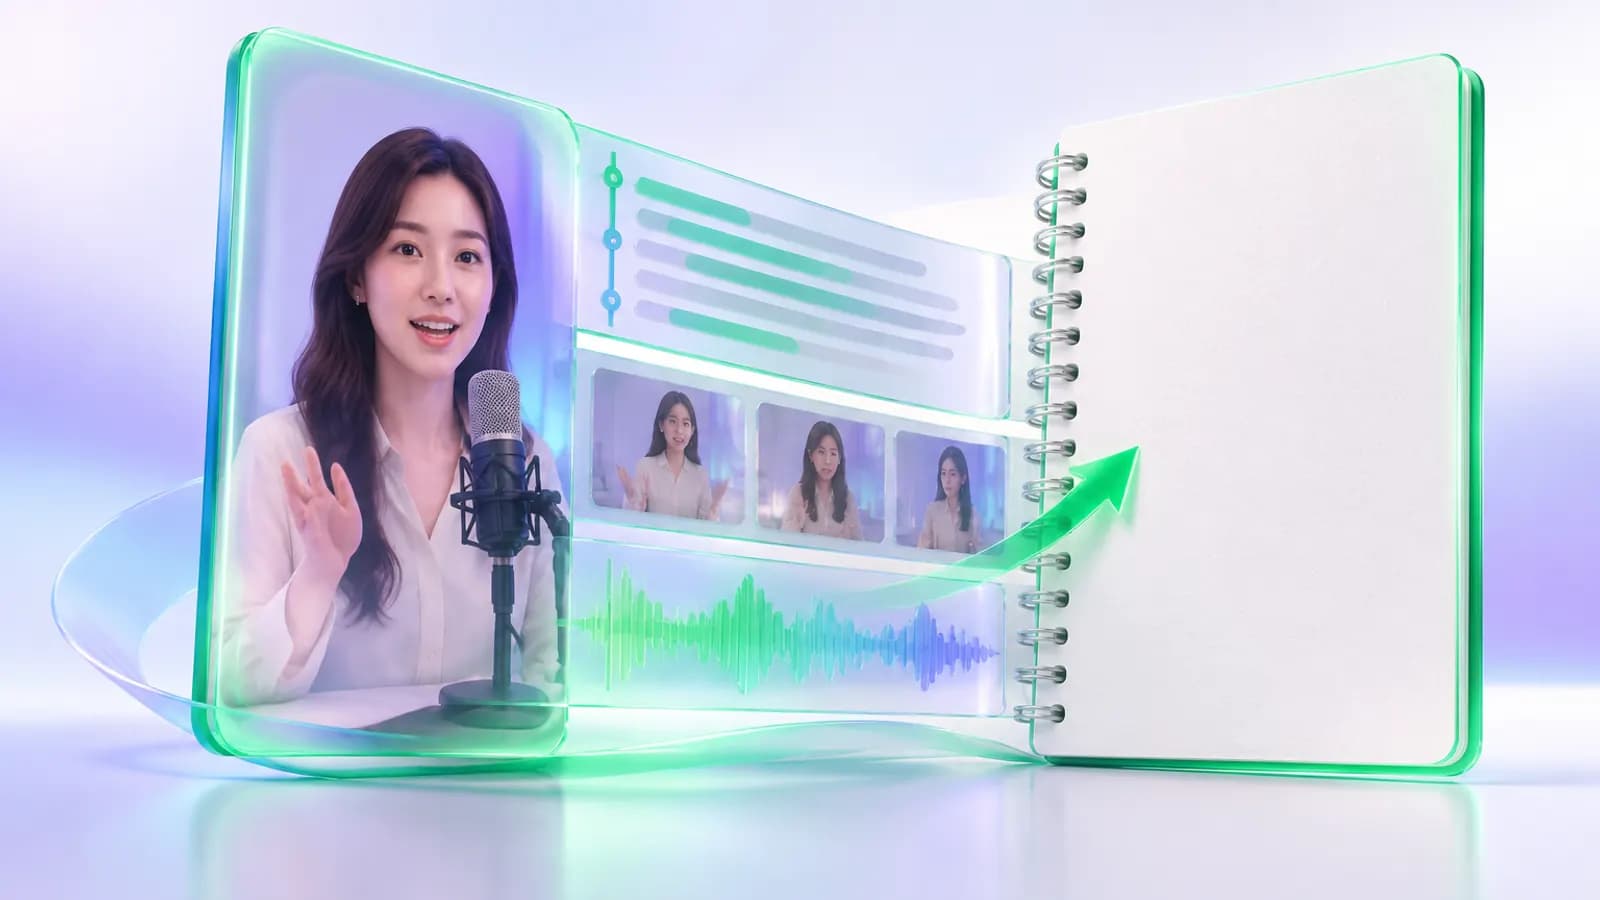
视频号上的口播视频,大多是一个人对着镜头讲两三分钟:讲一段亲身经历,给三条提醒,最后落到一个观点。看起来简单,自己一开口就发现难:开头怎么让人停下来,哪句话后面该停一下,什么时候该切一个画面,全靠感觉。
想学一条讲得好的口播,过去的办法是反复暂停,把原话一句句敲下来。Beav 把这件事变成一次“拆解”:每句话带着时间戳转成文字,每一镜拍了什么写成脚本,整条视频怎么推进写成结构模板,结果存进素材库并记着出处。存是积累的第一步,拆是第二步,改成自己的口播稿是第三步。
适合谁
- 在视频号做知识分享、本地生活、职场经验的口播博主,想研究同类账号怎么讲。
- 做私域和社群的运营,要把一条好视频的话术变成团队能照着练的稿子。
- 刚开始做口播、对着镜头不知道怎么组织一段话的新人。
怎么用
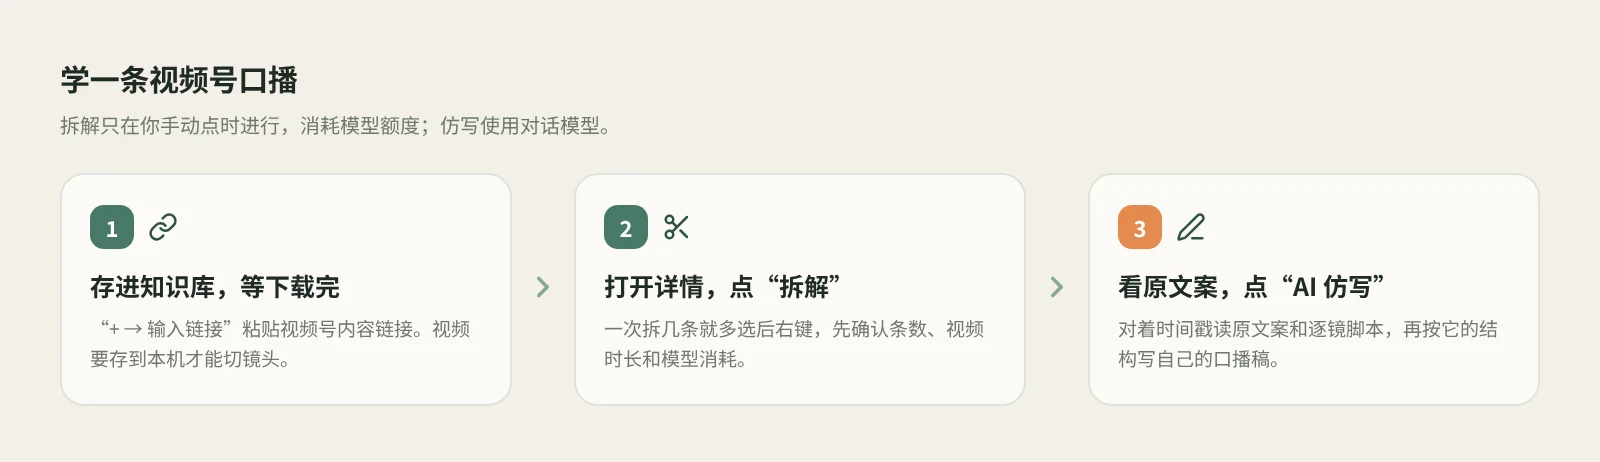
- 先把视频存进知识库。 在知识库点“知识库”旁的“+”,选“输入链接”,粘贴可识别的视频号内容链接或分享文案。完整做法见视频号刷到的好内容怎么不丢。
- 等视频下载到本机。 卡片显示“下载中”时还拆不出镜头。切镜头、出分镜片段和配乐都要视频已经存到本地。
- 打开详情,点“拆解”。 想一次拆几条同类口播,在列表里多选后右键“拆解选中的 N 项”,开始前确认条数、视频时长和模型消耗,一批最多 100 条。
- 对着原文案看节奏。 点镜头缩略图或时间,视频跳到那里。切点不准,用“并入上一镜”或“从播放处切开”调整,以后重新拆解会沿用。
- 点“AI 仿写”,写自己的口播稿。 在详情右上角点“AI 仿写”,Beav 开一个新对话,带上这条视频的引用和仿写技能。补充你的要求后手动发送。
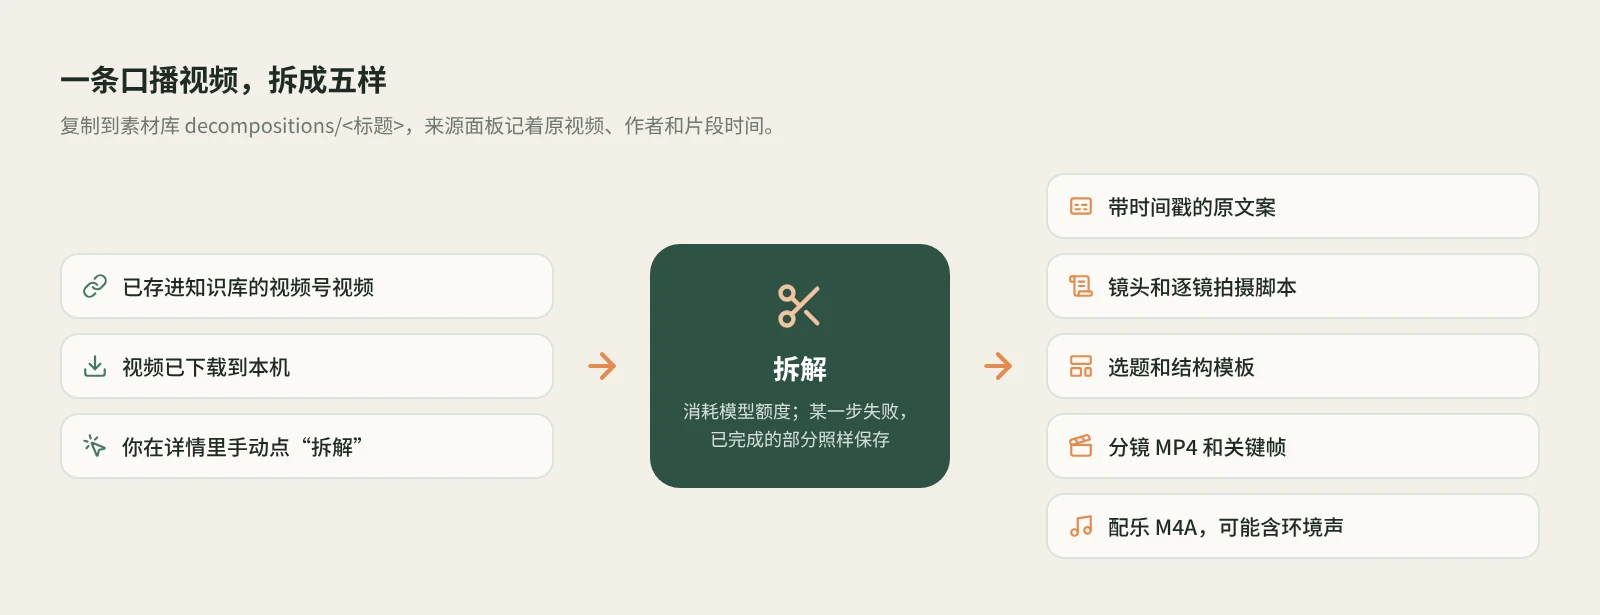
带时间戳的原文案:口播的骨头。 博主说的每句话转成文字,每句标着时间。把它从头读一遍,你会看到开头第一句用了多久,哪里一句话特别短,哪里连着讲了一大段。好的口播节奏感,往往就藏在这些长短里。
镜头和逐镜拍摄脚本:说到哪句换画面。 口播看着是一个人讲到底,其实常常在中间切近景、插一张图、换一个角度。逐镜拍摄脚本按顺序写出每一镜拍了什么、怎么拍,和原文案对着看,就知道哪句话配了画面,哪一段只靠人撑住。
选题和结构模板:先讲什么后讲什么。 结构模板写出这条视频怎么开场、怎么展开、怎么收尾。选题同时加进选题中心,以后翻得到。
分镜 MP4、关键帧和配乐 M4A。 视频按镜头切开,每一镜一个 MP4 和一张关键帧。配乐取自没人说话但有声音的区间,口播视频里这类区间不多,可能只是片头片尾,也可能夹着环境声,人声和音乐不会分开,用之前先听一遍。
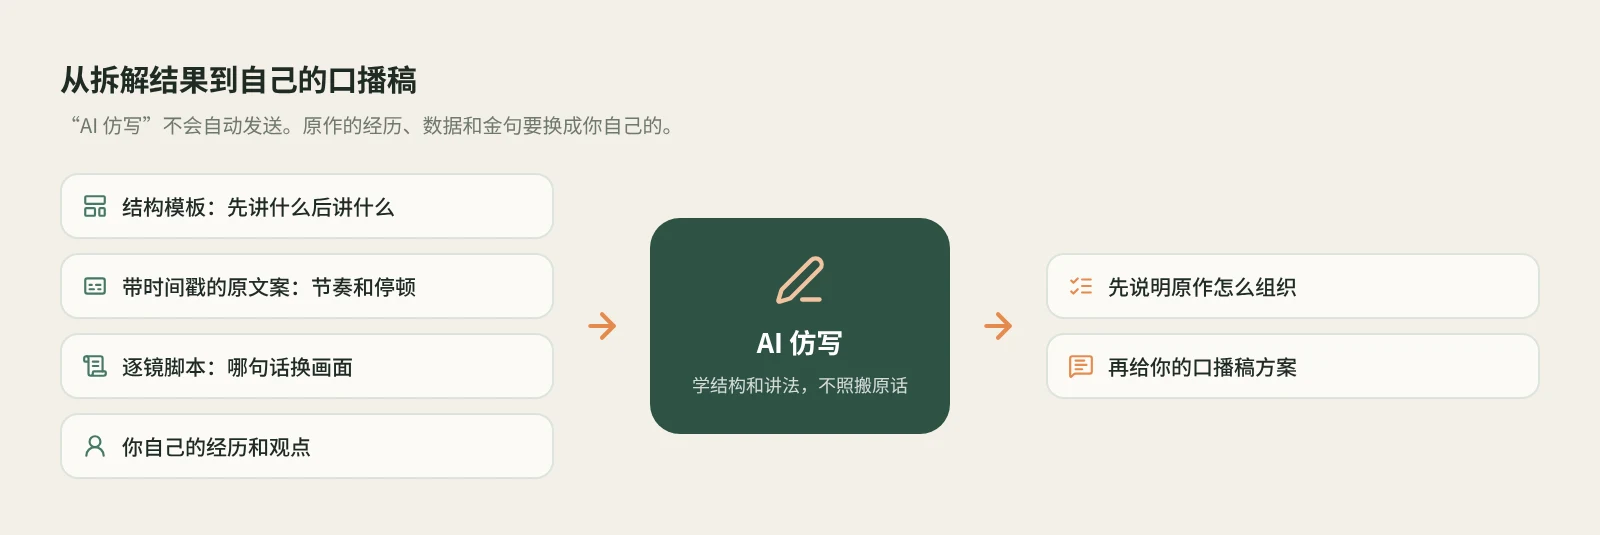
改成自己的口播稿。 仿写时说清楚保留什么、换什么,比如:“保留开头那句反问和‘一段经历加三条提醒’的结构,换成我做社区团购三年踩过的坑,口播控制在两分钟。”助手会先讲原作怎么组织,再给新稿的方案。原作里的经历、数据和金句是别人的,写进你的稿子要换成你自己的。更多写法见AI 仿写怎么才不是换词。
哪里消耗额度? 用输入链接保存视频号视频,走采集服务,需要已登录或已配置采集 API,按规则消耗额度。拆解另外消耗模型额度:原文案、选题和结构、拍摄脚本分别用到转写、对话和视频理解能力。仿写使用对话模型。
和常用做法比有什么不同
| 手动拉片 | 剪映识别字幕 | 单独的扒配乐工具 | Beav 拆解 | |
|---|---|---|---|---|
| 擅长什么 | 每一句都是自己听出来的,体会最深 | 识别完直接在时间线上改,给自己的视频配字幕很顺手 | 专门处理音频,有的能识别曲名或分离人声 | 原文案、逐镜脚本、结构、片段和配乐一次拆完 |
| 拿到什么 | 笔记和截图 | 字幕文字 | 一段音频 | 选题、结构模板、逐镜拍摄脚本、带时间戳原文案、分镜 MP4、关键帧、配乐 M4A |
| 出处 | 自己记 | 在剪辑工程里 | 通常自己记 | 来源面板记着原视频、作者和片段时间 |
| 接着写稿 | 自己动手 | 自己动手 | 不涉及 | “AI 仿写”带着这条视频开新对话 |
| 成本 | 免费,费时间 | 以剪映规则为准 | 视工具而定 | 消耗模型额度 |
真想练出自己的口播感,手动拉片、跟着念几遍还是最扎实的,Beav 拆出来的东西也要你自己读过、判断过才算数。只是给自己的视频配字幕,剪映更顺手;想知道曲名或要干净伴奏,专门的音频工具更合适,Beav 不识别曲名,也不做人声分离。Beav 适合把一批同类口播拆开攒起来,需要时按出处找回、接着写稿。
边界和注意
- 视频要已经下载到本机。 “下载中”或下载失败的条目拆不出镜头、片段和配乐。拆解只在你手动点时进行,保存不会自动拆解。
- 结果不完整,先看原因。 看结果底部的原因、媒体下载进度和模型配置。某一步失败时,已完成的部分照样保存。
- 重新拆解不覆盖你的修改。 素材库里改过的版本会保留,有变化的内容另存一份。调整切点后要重新拆解才出新片段,旧片段不会删除。共享空间没有拆解入口。
- AI 仿写不会自动发送,Beav 也不会替你发布。 稿子写好、拍好、发出去,都由你自己来。
- 拆下来的东西供你研究参考。 仿写学的是结构和讲法,不是搬运原话和画面。片段、关键帧和配乐要用进发布或商用的作品,先取得作者授权。
下一步
- 视频号视频从保存到仿写的完整流程,看视频号视频怎么存、拆解和仿写。
- 仿写怎么写出自己的东西,看AI 仿写怎么才不是换词。为什么要长期攒素材,读总纲篇《积累即壁垒》。
- 完整说明见文档拆解视频与笔记。
适用于 Beav 桌面端 2.9,核对日期 2026-11-03。