
要点速览
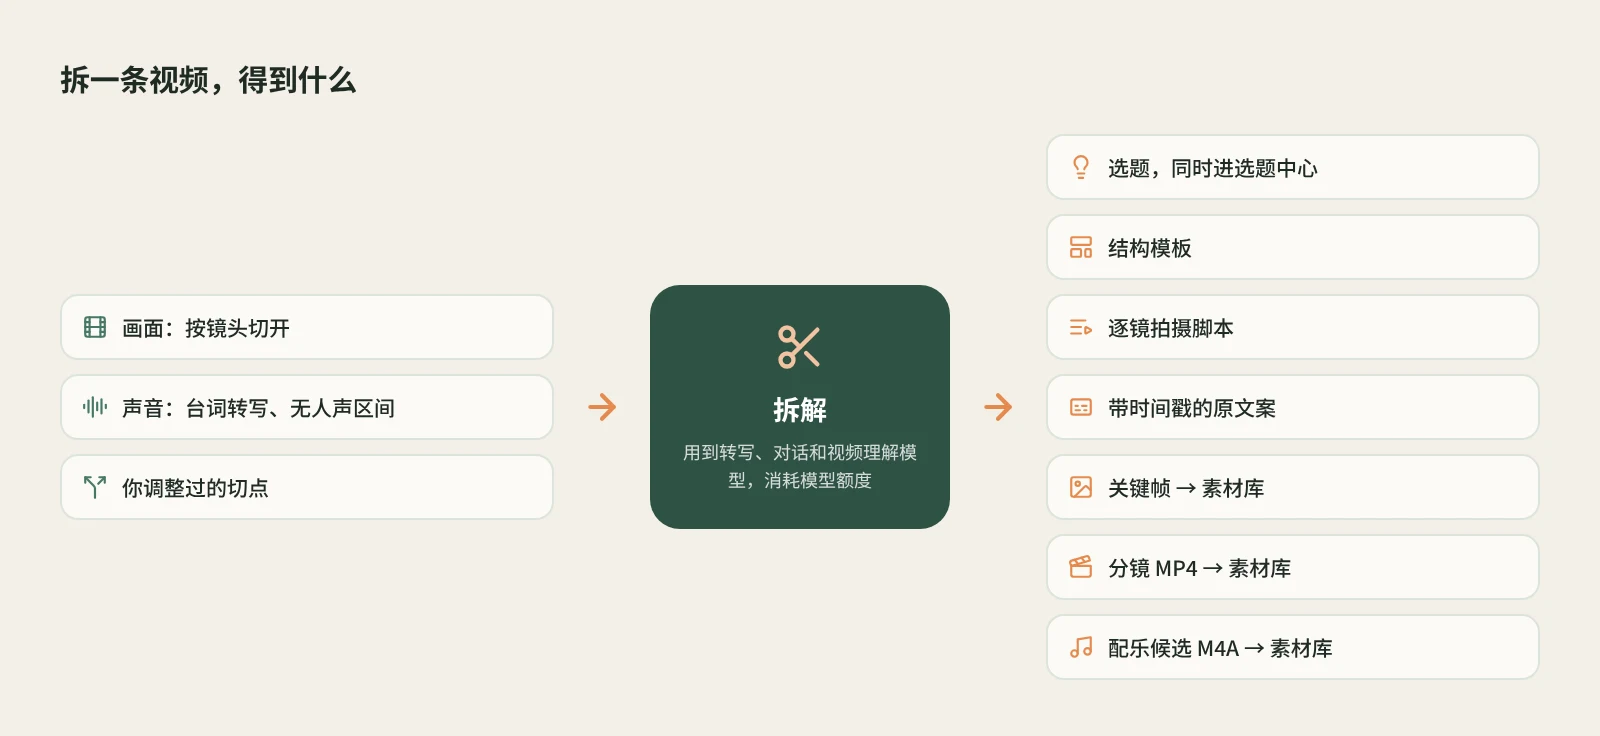
- 在 Beav 知识库打开一条已保存的视频,点“拆解”,就能得到选题、结构模板、镜头列表、逐镜拍摄脚本和带时间戳的原文案。
- 拆出来的不只是文字:文案、关键帧、分镜 MP4 和配乐候选会复制进素材库,选题同时进选题中心,做自己的视频时可以直接取用。
- 切点不准可以手动调,“并入上一镜”“从播放处切开”之后重新拆解就会按新切点出片段。拆解会消耗模型额度。
拉片是学视频最扎实的办法:一帧帧看,记下每个镜头拍了什么、说了什么、多长。问题是太慢,一条一分钟的视频认真拉下来要半小时,还得自己截图、剪片段、整理文案。
Beav 的拆解把这些体力活先做掉:把一条视频切成镜头,每个镜头配上画面说明、台词和时间,再把片段和关键帧存成可复用的素材。你要做的是看懂它为什么这么拍。
图文笔记的拆解和仿写方法,另一篇爆款拆解与仿写已经讲过。这篇只讲视频。
适合谁
- 做口播、探店、开箱、教程类短视频,想学对标视频节奏的创作者。
- 需要给团队出分镜脚本的编导和运营。
- 想把好镜头、好配乐留下来二次剪辑参考的人。
怎么用
开始前,先把视频保存到本地知识库,比如在知识库点“+”选“输入链接”,粘贴小红书或抖音视频链接。视频必须已经下载到本机,才能切镜头和提取片段。
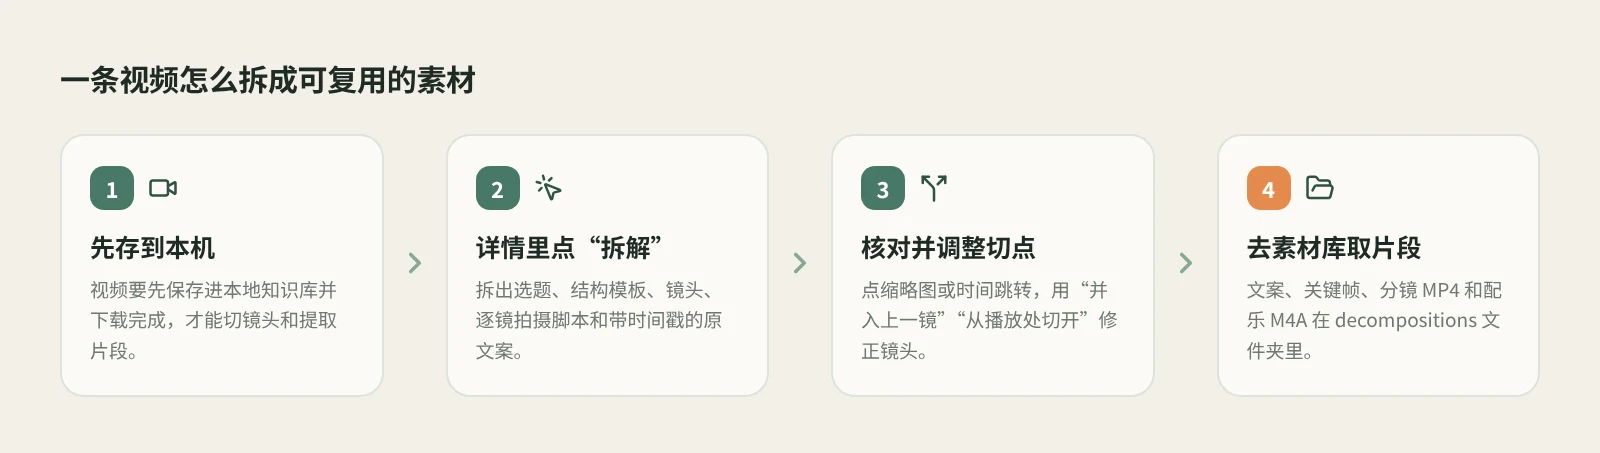
- 打开视频详情,点“拆解”。 在知识库里打开那条视频,点“拆解”。卡片显示“下载中”时先等媒体下载完。
- 展开结果看五部分。 选题、结构模板、镜头、逐镜拍摄脚本、带时间戳的原文案。逐镜脚本写的是每一镜拍什么、怎么拍;原文案每句都带时间,方便对照画面。
- 对着视频核对镜头。 点镜头缩略图或时间,视频会跳到对应位置。两镜其实是一镜,用“并入上一镜”;一镜里有明显转场,播到那里用“从播放处切开”。之后再拆解会沿用你调过的切点。
- 去素材库取片段。 结果会复制到素材库的
decompositions/<标题>文件夹:文案、关键帧、分镜 MP4 和配乐 M4A。来源面板保留原视频、作者和片段时间。选题同时加入选题中心。
调整切点后,需要重新拆解才会生成新的片段,旧片段不会删除。重新拆解时,素材库里你改过的版本会保留,有变化的内容另存一份。
和手动拉片、通用 AI 对话比有什么不同
| 手动拉片 | 把视频交给通用 AI(如 Gemini、ChatGPT) | Beav 拆解 | |
|---|---|---|---|
| 得到什么 | 你自己的笔记和截图 | 一段文字分析,可以追问 | 选题、结构模板、逐镜脚本、带时间戳原文案 |
| 片段和关键帧 | 自己剪、自己截 | 一般只给文字 | 分镜 MP4 和关键帧自动存进素材库 |
| 切点能不能改 | 完全由你决定 | 重新描述再问一次 | 并入上一镜、从播放处切开,重新拆解沿用 |
| 擅长什么 | 理解最深,练的是自己的眼光 | 提问灵活,适合聊“为什么这样拍” | 结果落成素材,直接接到选题和剪辑 |
| 成本 | 时间 | 各自的会员规则 | 消耗模型额度 |
手动拉片的价值是训练自己的判断,这一点任何工具都替代不了;通用 AI 适合开放式地追问一条视频。Beav 的拆解更像一个拉片助手:把切镜头、记台词、截关键帧这些重复劳动做完,结果直接变成你素材库里的东西。
边界和注意
- 转写、选题结构、拍摄脚本分别要用到转写、对话和视频理解能力,都会消耗模型额度。某一步失败时,已完成的部分仍会保存,可以看结果底部的原因。
- 视频超过视频理解的大小上限时,会先生成低清副本;压缩后仍过大,就跳过拍摄脚本并说明原因。
- 配乐候选取自视频里没有人声但有声音的区间,可能混着环境声。它不是人声分离,不能把人声和背景音乐分开。
- 共享空间不提供拆解入口。拆出来的片段和配乐只用于学习参考,发布或商用前请确认素材授权。
下一步
- 一次要拆很多条,看批量拆解。
- 先把视频存下来:抖音视频怎么保存到电脑。
- 完整说明见文档拆解视频与笔记,素材怎么管理见素材管理。
适用于 Beav 桌面端 2.9,核对日期 2026-10-21。